Tiempo de lectura: 11 minutos
Hace unos días leí un post en LinkedIn que no me quito de la cabeza. Lo escribía un ingeniero con dos semanas en una empresa grande: allí todo se genera. Las especificaciones, el código, los tests, los tickets y hasta las resoluciones de los tickets. Dirección repite que "el código ya no es el cuello de botella, así que entregad más". La gente trabaja doce horas al día pulsando Enter, y nadie lee nada de lo que sale.
Me gustaría decir que es una empresa rara. No lo es. Es la versión extrema de algo que veo, en dosis más suaves, en muchos equipos con los que trabajo: la IA ha entrado para hacer exactamente lo mismo que antes, solo que en más cantidad. Ese camino tiene dos peajes que casi nadie está contando. Y un coste de oportunidad que es todavía mayor.
Todo se genera y nadie lee nada: la escena
La empresa del post es fácil de caricaturizar, así que conviene mirar la versión suave, que es la que probablemente tienes cerca. Se parece a esto.
Un equipo recibe licencias de una herramienta de programación con IA. La primera semana es emocionante: lo que costaba dos días sale en una tarde. La segunda, alguien de dirección lo ve y saca la conclusión lógica: si va el doble de rápido, caben el doble de cosas. El plan del trimestre no cambia; lo que cambia es que ahora "hay margen". Los plazos se mantienen, o se acortan.
Al mes, el código que llega a revisión se ha multiplicado. Las revisiones, no. El que revisa tiene el mismo tiempo que antes y ahora le entran tres veces más líneas. Así que empieza a aprobar por confianza. Los tests existen, muchos, y pasan; pero nadie ha comprobado qué comprueban. La documentación está impecable y nadie recuerda haberla escrito. Y cuando algo falla en producción, la conversación empieza con una frase nueva: "esto lo generó la IA, no sé muy bien qué hace".
En el caso que usamos en formación, GymTonic, esto le pasa al equipo de GymApp en el Sprint en que Nuria, la product owner, descubre que puede generar historias de usuario con criterios de aceptación en minutos. El backlog pasa de cuarenta a ciento veinte elementos en dos semanas. El equipo no va más rápido: va igual, pero con una lista tres veces más larga delante. Y con la sensación de ir siempre por detrás.
Si en tu empresa se mandan las herramientas desde arriba, se mantienen las fechas y nadie ha cambiado nada en cómo se revisa, se decide o se prioriza, reconoce la escena. Es la misma.
Trabajar igual con diez veces más volumen: por qué es una trampa
La lógica de "el código ya no es el cuello de botella, así que entregad más" tiene un fallo que cualquiera que haya trabajado con el modelo de producción que inventó Toyota reconoce al momento: acelerar una etapa que ya no es la lenta no aumenta lo que sale por el final. Solo apila trabajo delante de la siguiente.
Durante veinte años, escribir código fue la parte lenta del desarrollo de software. Todo lo demás —decidir qué construir, revisarlo, entenderlo, comprobar que sirve— cabía en el hueco que dejaba. Cuando escribir se vuelve casi gratis, el cuello de botella no desaparece: se mueve. Ahora lo lento es leer, decidir y entender. Y esas tres cosas las sigue haciendo una persona, con las mismas horas que tenía.
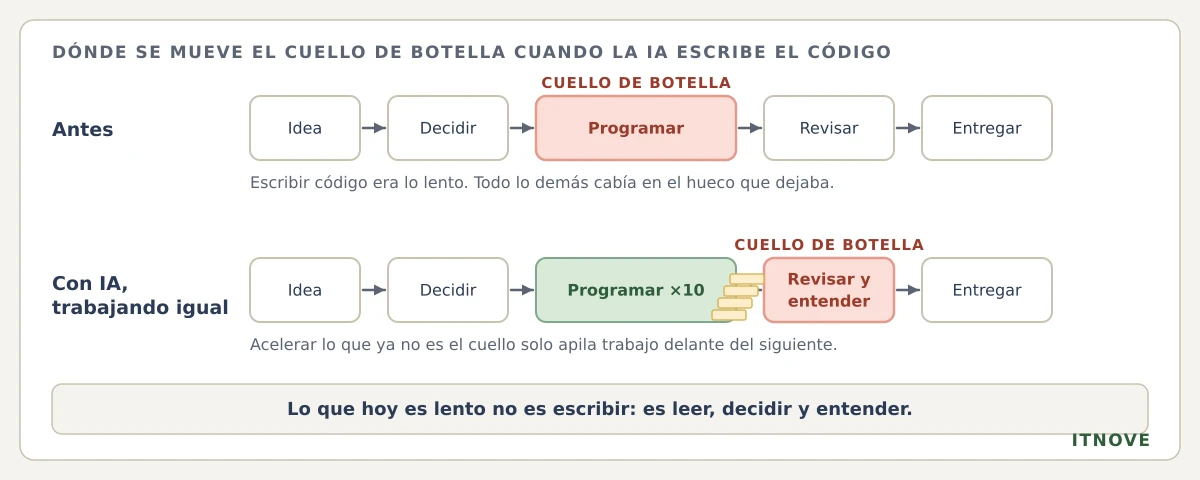
Por eso "trabajar igual con más volumen" es una trampa y no un atajo. El proceso, los roles y el Sprint siguen diseñados para un mundo donde lo escaso era la escritura. Si no se rediseña nada, todo el aumento de producción se convierte en inventario: código sin revisar, especificaciones sin discutir, tickets resueltos que nadie ha validado. Y el inventario, en software igual que en una fábrica, no es un activo. Es un coste que todavía no se ha cobrado.
Es la misma idea que desarrollo en la última milla de la adopción de IA: la tecnología entra en modo empuje, buscando dónde justificarse, y lo que hace falta es que sea el problema el que tire de ella. Aquí el problema nunca fue "no escribimos suficiente código".
Las dos deudas: la técnica que ya conocías y la cognitiva que no ves
Cuando nadie lee lo que se genera, se acumulan dos deudas a la vez. Una se ve; la otra, no. Y la que no se ve es la peor.
La deuda técnica ya la conocías, solo que ahora crece más rápido de lo que nadie la había visto crecer. Código que nadie ha leído y que resuelve el caso feliz de una forma que nadie eligió. Tests que pasan porque comprueban lo que el propio generador decidió comprobar. Documentación correcta gramaticalmente y sin validar contra la realidad. Se paga como siempre: en bugs, en reescrituras y en horas de arreglo que no estaban en el plan. Es cara, pero es conocida. Se ve en el repositorio.
La deuda cognitiva es distinta. Es la distancia entre lo que el sistema hace y lo que el equipo entiende de él. Aparece cuando la gente deja de leer y pasa a aprobar. Cuando las decisiones de diseño las toma el generador por defecto porque nadie las discutió. Cuando nadie en la sala puede explicar por qué existe un módulo. No sale en ninguna métrica del repositorio. Se ve en la gente: en el incidente que tarda tres horas porque nadie sabe por dónde empezar, en la persona nueva que no tiene a quién preguntar, en el miedo a tocar algo porque no se sabe qué más se rompe.
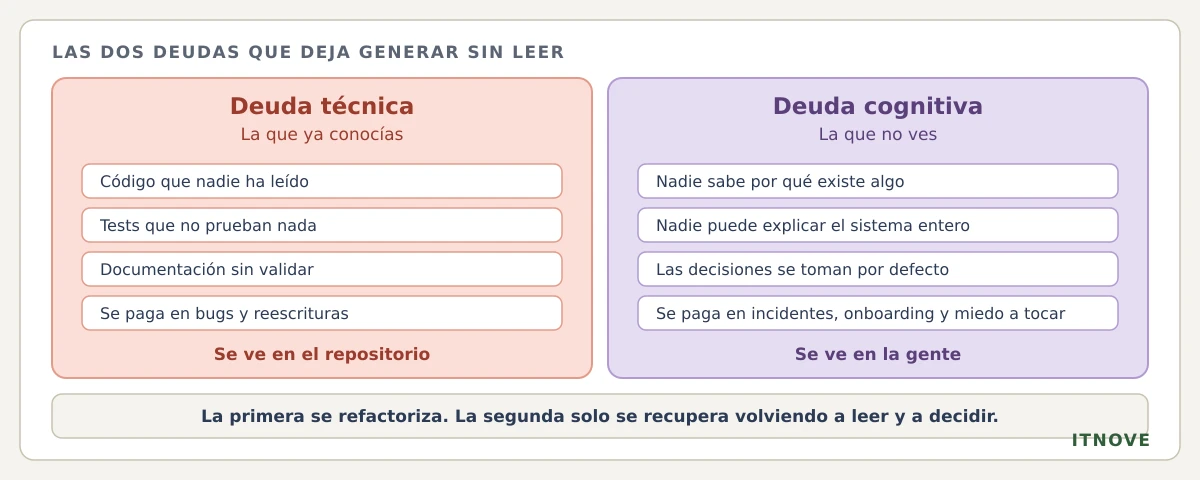
Hay una diferencia práctica que importa mucho. La deuda técnica se refactoriza: se puede pagar con más trabajo, incluso con más IA. La deuda cognitiva, no. Solo se recupera volviendo a leer y volviendo a decidir, que es exactamente el trabajo que se había dejado de hacer. Cuanto más tiempo pase, más caro sale. La gente que podía haber entendido el sistema ya no está, o ya no se acuerda.
En los equipos que trabajan con Scrum, esto se detecta pronto si la Definición de Done incorpora lo que ha cambiado: que algo esté "hecho" tiene que incluir que una persona distinta de quien lo generó lo ha leído y lo entiende. Si la DoD no lo dice, la deuda cognitiva entra por defecto.
Lo que se pierde por el camino: priorizar mejor y experimentar más
Lo más caro de usar la IA para hacer lo mismo no son las deudas. Es lo que se deja de hacer.
La ventaja real de que escribir sea casi gratis no está en producir más de lo que ya se producía. Está en que cambia lo que es posible antes de decidir. Durante años, un equipo elegía qué construir con muy poca información. Comprobar una idea costaba días, y solo se podía comprobar una. Ahora se pueden montar tres prototipos de una funcionalidad en una tarde y ponerlos delante de usuarios reales antes de comprometer un Sprint. Se pueden probar cinco formas de un flujo de alta y medir cuál convierte. Se puede explorar el espacio de soluciones en vez de apostar a la primera que a alguien le pareció razonable.
Eso es priorizar mejor, con evidencia en vez de con opinión. Y es lo que hace posible el descubrimiento de producto continuo que hasta ahora solo se permitían los equipos con mucho margen. Es también lo que cambia la conversación con dirección: no "hemos entregado más", sino "hemos probado cuatro caminos y este es el que mueve la métrica".
La empresa del post ha renunciado a todo eso. Ha usado la capacidad de generar para multiplicar la ejecución de un plan que se decidió con la misma poca información de siempre. Más código para las mismas decisiones. Es como comprar un telescopio y usarlo de pisapapeles.
Si tu equipo trabaja con OKR, la prueba es sencilla: mira si desde que hay IA ha cambiado cuántas hipótesis probáis por trimestre, o solo cuántas tareas cerráis. Lo desarrollo en OKR + IA: objetivos que la IA ayuda a ejecutar, no a inflar.
Divergir es barato; converger sigue siendo el trabajo
Hay una forma de pensarlo que a mí me ayuda a explicárselo a los equipos, y que el post de LinkedIn resume bien: la IA es espectacular para divergir. Diez prototipos antes de comer, todas las variantes de una solución, andamiaje de tests para cada una. Pero alguien tiene que converger: elegir qué entra en el producto, decidir qué significa "bueno" y descartar el resto. La empresa del post automatizó la divergencia y se saltó la convergencia. El resultado es un producto que se llena de relleno.
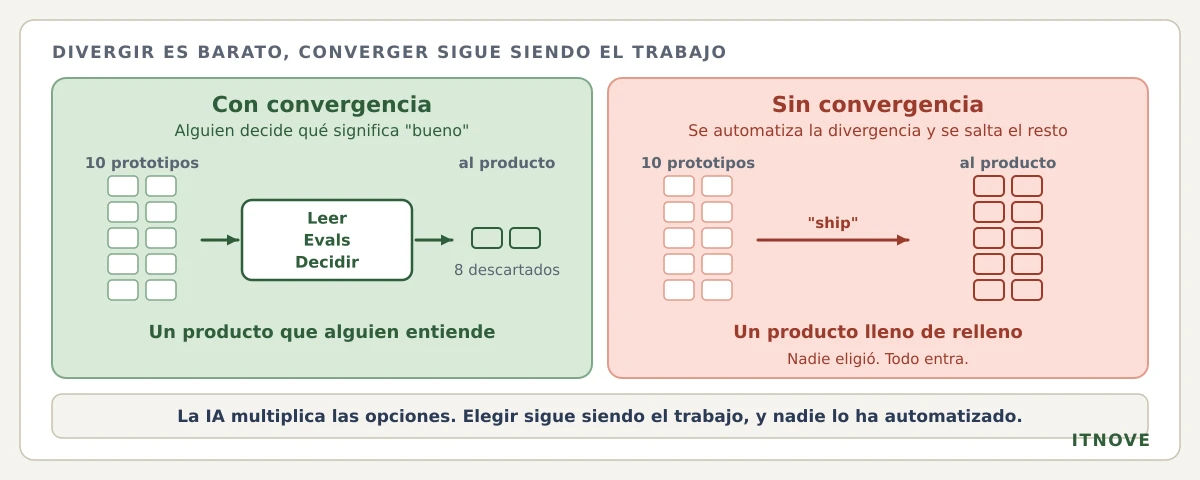
Converger siempre fue el trabajo de verdad de un product owner o de un product manager. Lo que ha cambiado es que ahora es el único que no se puede delegar, y por eso vale más que nunca. Tres cosas concretas lo hacen posible:
Leer. En una empresa donde nadie lee, leer es una ventaja competitiva. La persona que llega a la reunión habiendo usado el prototipo, con tres observaciones concretas de dónde se rompe, se convierte en el sitio por donde pasan las decisiones. Los ingenieros que están enterrados en salida generada agradecen a alguien que se la tome en serio.
Criterios ejecutables. "Entregad más" se convierte en "entregad lo que pasa" en cuanto hay una definición de qué es pasar. En desarrollo con agentes se llaman evals: conjuntos de casos que dicen si el resultado sirve, y que se corren cada vez que algo cambia. Con eso nunca hace falta discutir con dirección sobre velocidad. Se define el listón, y el listón discute solo. Lo cuento en la dinámica de los agentes de IA y, para specs que una persona y un agente puedan leer igual, en Given-When-Then y EARS.
Un filtro de criterio. El volumen de prototipos debe dispararse. El volumen de lo que se entrega necesita un filtro, y ese filtro tiene dueño. Si nadie lo tiene, lo tiene el generador. Y el generador no tiene criterio.
Cinco cambios para salir (o para no entrar)
Nada de esto exige parar la IA ni frenar al equipo. Exige cambiar cinco cosas de cómo se trabaja, y las cinco se pueden hacer en un mes.
| Cambio | Qué se decide y quién | Qué queda por escrito | De dónde sale el tiempo |
|---|---|---|---|
| 1. "Hecho" incluye "leído por otra persona" | El equipo, en la retrospectiva: nada generado se considera terminado hasta que alguien distinto de quien lo generó lo ha leído y puede explicarlo. | La Definición de Done, con la frase literal. | Se descuenta de la capacidad del Sprint: si revisar cuesta el 30 %, el Sprint planifica el 70 %. |
| 2. Acuerdos de uso, explícitos | El equipo: qué se genera y qué no, qué se marca como "borrador de IA", qué decisiones no se automatizan. | Los acuerdos de equipo, en el repositorio, revisados en cada retro. | Una retrospectiva temática para arrancar; después, un punto fijo de la retro. |
| 3. Un listón ejecutable antes que un plazo | Producto define qué significa "pasa" para cada funcionalidad; ingeniería lo convierte en tests o evals que se corren siempre. | Los criterios, en la spec; los evals, en el pipeline. Ver code review con IA. | Se escribe antes de generar, no después: sustituye a la corrección posterior. |
| 4. Medir resultados, no volumen | Dirección deja de mirar líneas, tickets o "entregas" y pasa a mirar qué ha cambiado para el usuario y el negocio. | Un panel con dos o tres métricas de resultado y las de flujo que dicen si la cola crece. | Ninguno extra: sustituye a la reunión de "cuánto hemos entregado". |
| 5. Presupuesto de exploración con criterio de descarte | Producto reserva parte de cada Sprint a prototipos que se van a tirar, y fija de antemano qué dato decide si algo sigue. | La hipótesis, la métrica y la fecha de decisión, por cada experimento. | Sale del volumen que antes se dedicaba a construir cosas sin comprobar. |
Dos avisos sobre la tabla. El primero: el cambio 1 es el que más resistencia genera, porque a corto plazo baja el número de cosas que se entregan. Es justo lo que tiene que pasar: estaba entregando inventario. El segundo: el cambio 5 es el que de verdad captura la ventaja de la IA, y es el que casi nadie hace, porque nadie lo ha pedido. Nadie pide "probad más cosas y tirad la mayoría". Hay que proponerlo.
Si no sabes por cuál empezar, empieza por el 1 y el 4. Sin el 1, la deuda cognitiva sigue entrando. Sin el 4, dirección seguirá pidiendo volumen, porque es lo único que ve.
Si estás empezando: por dónde no ir
Si tu empresa todavía no ha adoptado la IA en serio y está decidiendo cómo, tienes una ventaja enorme: no has acumulado ninguna de las dos deudas. Estas tres decisiones evitan la mayor parte del problema.
No mandes herramientas y mantengas las fechas. Es la combinación exacta que produce la empresa del post. Si se introduce IA en un equipo, el primer Sprint se dedica a averiguar qué cambia en cómo se revisa y se decide, no a ir más rápido. Va a ir más rápido de todas formas. Lo que hay que decidir es en qué.
Elige un proceso, no una herramienta. En vez de "todo el mundo tiene licencia", "el equipo de altas va a probar tres variantes del flujo de registro y medir cuál convierte". Un problema con dueño y una medida, y que la tecnología entre por ahí. Es el enfoque que propongo en la última milla, y el diagnóstico organizativo de IA sirve para ver por dónde empezar.
Decide antes quién responde de qué. Qué puede generar la IA sin revisión, qué exige una lectura, qué no se automatiza. No hace falta un comité: hace falta una política de uso de IA de una página que el equipo haya discutido. Sin eso, la respuesta a "quién responde de esto" será siempre "lo generó la IA". Que es lo mismo que nadie.
Preguntas frecuentes
¿Cómo saber si mi empresa está usando mal la IA? Hay tres señales que aparecen juntas: el volumen de lo que se produce ha subido mucho y el de lo que se revisa no; las fechas se han mantenido o acortado sin que haya cambiado nada en cómo se decide o se prioriza; y ante un fallo, la explicación empieza por "esto lo generó la IA". Si se dan las tres, la empresa está usando la IA para hacer lo mismo de siempre con más volumen, y está acumulando deuda técnica y cognitiva.
¿Qué es la deuda cognitiva en el desarrollo de software? Es la distancia entre lo que un sistema hace y lo que el equipo que lo mantiene entiende de él. Crece cuando el código, los tests o la documentación se generan sin que nadie los lea, y las decisiones de diseño las toma el generador por defecto. A diferencia de la deuda técnica, no se ve en el repositorio ni se refactoriza: se ve en incidentes largos, en gente nueva sin nadie a quien preguntar y en miedo a tocar el sistema, y solo se recupera volviendo a leer y a decidir.
¿La IA hace que el código deje de ser el cuello de botella? Sí, y por eso el cuello de botella se mueve, no desaparece. Lo lento pasa a ser leer, decidir y entender, que siguen haciendo personas con las mismas horas. Acelerar la escritura sin rediseñar la revisión y la toma de decisiones solo apila trabajo delante de la siguiente etapa, igual que en cualquier proceso de producción.
¿Cuál es la ventaja real de la IA para un equipo de producto? Que comprobar una idea antes de decidir se vuelve barato: varios prototipos en una tarde, varias variantes de un flujo medidas con usuarios reales, hipótesis probadas antes de comprometer un Sprint. Es decir, priorizar con evidencia y experimentar más. Usar la IA solo para producir más rápido lo que ya se había decidido renuncia justo a eso.
¿Qué debería cambiar un product owner cuando su equipo usa IA? Tres cosas: leer de verdad lo que se genera, porque en un equipo donde nadie lee la lectura es donde se toman las decisiones; definir de forma ejecutable qué significa "bueno" para cada funcionalidad, para que el listón discuta en lugar del plazo; y ser el dueño del filtro entre lo que se prototipa (mucho) y lo que se entrega (poco). Converger siempre fue su trabajo; ahora es el único que no se puede delegar.
¿Cómo empezar con IA sin caer en este problema? No introducir herramientas manteniendo las fechas; elegir un proceso concreto con dueño y una medida en vez de repartir licencias; y decidir antes qué puede generar la IA sin revisión, qué exige lectura y qué no se automatiza, en una política de una página que el equipo haya discutido. El primer Sprint con IA se dedica a averiguar qué cambia en la forma de revisar y decidir, no a ir más rápido.
Por dónde seguir
Si quieres situar a tu organización antes de tocar nada, el diagnóstico organizativo de IA te da una foto en media hora, y las 7 preguntas que un directivo debería hacerse sobre la IA sirven para llevar esta conversación a quien está pidiendo "entregad más". Hace poco hice un webcast con Scrum.org sobre Scrum e IA que va exactamente de esto: qué tiene que cambiar en el equipo para que la IA mejore el impacto y no solo el volumen.
Recursos relacionados
- La última milla de la adopción de IA
- Cómo adaptar la Definición de Done al desarrollo con IA
- Acuerdos de equipo para usar IA
- Code review con IA: un pipeline que revisa specs y código sin frenar la entrega
- IA sin gobernanza es un riesgo: cómo Scrum y OKR amplifican (y protegen) tu IA
- Vibe coding vs Spec-Driven Development: cuándo escala cada uno
- Política de uso de IA para tu empresa