Tiempo de lectura: 12 minutos
Cada vez que hablamos de Spec-Driven Development (SDD) en un curso o en una empresa aparece la misma objeción: "esto es waterfall con otro nombre". Y casi siempre aparece también la respuesta contraria, igual de rotunda: "no, las specs son ligeras y se iteran".
Las dos frases tienen parte de razón, y las dos fallan por lo mismo: hablan de Spec-Driven Development en general. Escribir una spec antes de que el agente genere código puede ser justo lo que necesita un equipo. Y, en otro contexto, la forma más rápida de construir, y muy bien, algo que nadie quería.
- Por qué te importa: con agentes de IA, programar lo que dice una spec cuesta cada vez menos. Por eso el error caro ya no está en el código, sino en la spec: si describe algo que el cliente no necesita, el agente lo construye rápido y bien, pero no es lo que hacía falta. Y que SDD acabe siendo un waterfall depende del contexto, no del método.
- Qué aporta este artículo: dónde está exactamente el riesgo, cómo cambia según la etapa del ciclo de vida del producto (y de cada parte de él) y según el tipo de aplicación, y cómo combinar SDD con un dual track (descubrir y construir a la vez) para no especificar antes de tiempo.
- Qué te llevas: unas tablas para situar tu contexto, criterios para saber cuándo algo está listo para convertirse en spec y cómo lo aprendido vuelve a la Definición de Done.
Dónde está el riesgo de que SDD se convierta en waterfall
Spec-Driven Development consiste en escribir, antes de generar código, una especificación con el contexto, el alcance, los criterios de aceptación y las decisiones técnicas, para que personas y agentes construyan lo mismo. Lo explicamos en la guía de Spec-Driven Development.
El riesgo no está en escribir specs. Está en lo que se da por sabido al escribirlas. Estas son las señales de que el proceso se está pareciendo a un waterfall:
- Specs grandes y cerradas antes de aprender. Se especifica una funcionalidad completa cuando todavía no se sabe si resuelve el problema del cliente.
- La spec se firma y se entrega. Alguien la escribe, otro la ejecuta y nadie la vuelve a abrir aunque aparezca información nueva.
- Da pena tirar lo escrito. Como la spec costó mucho de escribir, se construye aunque ya se intuya que no es lo que hacía falta.
- El feedback llega tarde. El agente genera rápido, pero el primer usuario real ve el resultado cuando ya está todo construido.
- La velocidad tapa el error. El equipo entrega mucho y bien hecho, y tarda en descubrir que no era lo que había que hacer.
Y estas son las señales de que no lo es: specs pequeñas, de una parte del sistema que ya se entiende; specs que se reescriben cuando aparece algo nuevo; y feedback de usuarios o de producción en cada Sprint.
Por qué no se puede responder en general
Decir "SDD es waterfall" o "SDD no es waterfall" sin contexto es tan arriesgado como decir que todos los productos necesitan el mismo nivel de investigación de usuarios. Hay al menos dos variables que cambian la respuesta: en qué etapa del ciclo de vida está lo que vas a construir y qué tipo de aplicación es.
Las dos responden a la misma pregunta: ¿cuánto sabemos ya del problema, del cliente y de la técnica? Cuanto más se sabe, más útil es una spec detallada. Cuanto menos, más riesgo tiene escribirla demasiado pronto.
Primer eje: el ciclo de vida del producto (y de cada parte de él)
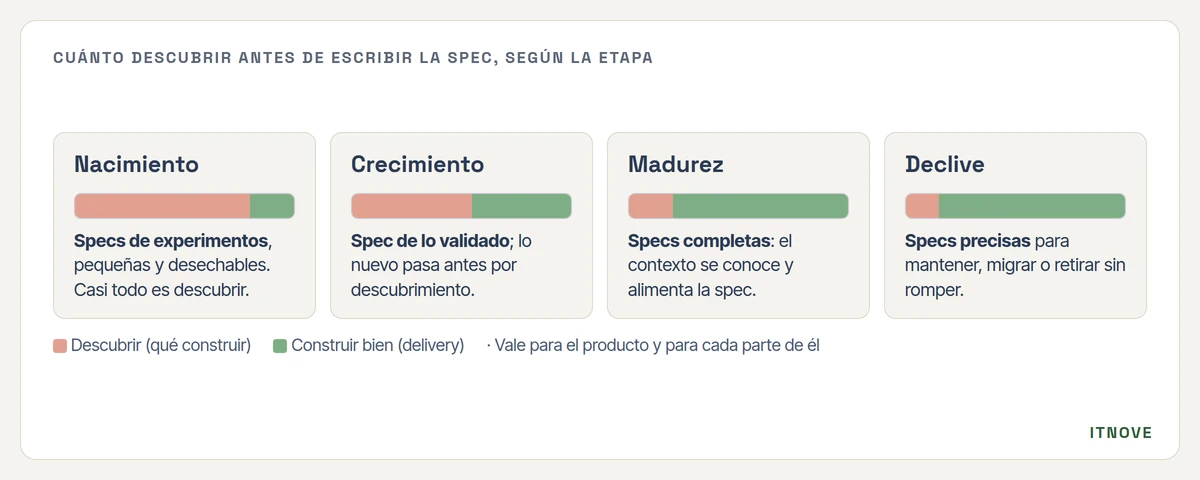
Un producto pasa por nacimiento, crecimiento, madurez y declive. En cada etapa cambia lo que se sabe y, con ello, lo que conviene especificar.
| Etapa | Qué se sabe | Qué hacer con las specs | Riesgo si se aplica mal |
|---|---|---|---|
| Nacimiento | Poco: ni el cliente, ni el modelo de negocio, ni a veces la técnica están claros | Specs de experimentos: pequeñas, para prototipos que se pueden tirar. Casi todo es descubrir | Especificar el producto entero antes de saber si alguien lo quiere |
| Crecimiento | El núcleo funciona, pero llegan clientes nuevos, decisiones de escala y de arquitectura | Spec de lo que ya está validado; lo nuevo pasa antes por descubrimiento | Congelar con specs decisiones que todavía se están moviendo |
| Madurez | Mucho: usuarios, contexto y arquitectura conocidos | SDD con poca exploración funciona bien: el contexto conocido alimenta la spec | Que la rutina impida ver un cambio de mercado o de tecnología |
| Declive | Mucho, y el objetivo es mantener, migrar o retirar | Specs precisas para no romper lo que funciona al cambiarlo | Invertir en specs detalladas de algo que se va a retirar |
El matiz más importante: la etapa no es solo del producto, también de cada parte. Un producto maduro puede tener un módulo en pleno nacimiento: un canal nuevo, una funcionalidad con IA, un mercado nuevo. Decidir el nivel de spec por producto entero es otra forma de generalizar.
Segundo eje: el tipo de aplicación
La otra variable es dónde está la incertidumbre. No es lo mismo una herramienta interna que un producto para miles de consumidores.
| Tipo de aplicación | Dónde está la incertidumbre | Cuánto descubrir antes de la spec |
|---|---|---|
| Interna, con usuarios conocidos | Poca en el cliente (están en la empresa y se les puede preguntar); a veces en la integración con otros sistemas | Poco: una conversación con los usuarios y una revisión técnica suelen bastar para escribir la spec |
| B2B o a medida para un cliente | En lo que el cliente necesita de verdad frente a lo que pide, y en el contexto técnico de su organización | Lo justo para validar con el cliente antes de comprometer alcance; la spec ayuda a cerrar el acuerdo, pero no sustituye a la validación |
| B2C con incertidumbre de cliente | Mucha en el cliente: no lo conoces, no puedes preguntarle cuando quieras y se va si no le sirve | Mucho en lo que toca a la experiencia y al valor; spec detallada solo de lo que ya se ha validado con usuarios |
| Empresa o producto nuevo | En todo a la vez: cliente, negocio y técnica | Casi todo: experimentos pequeños, prototipos y specs que se escriben para aprender, no para durar |
Esta distinción no es nueva. Ya la usábamos al hablar de integrar UX y Scrum con un dual track (te lo explico en el apartado siguiente): en desarrollos internos se puede validar hablando con el usuario; en productos para clientes externos, el descubrimiento es vital.
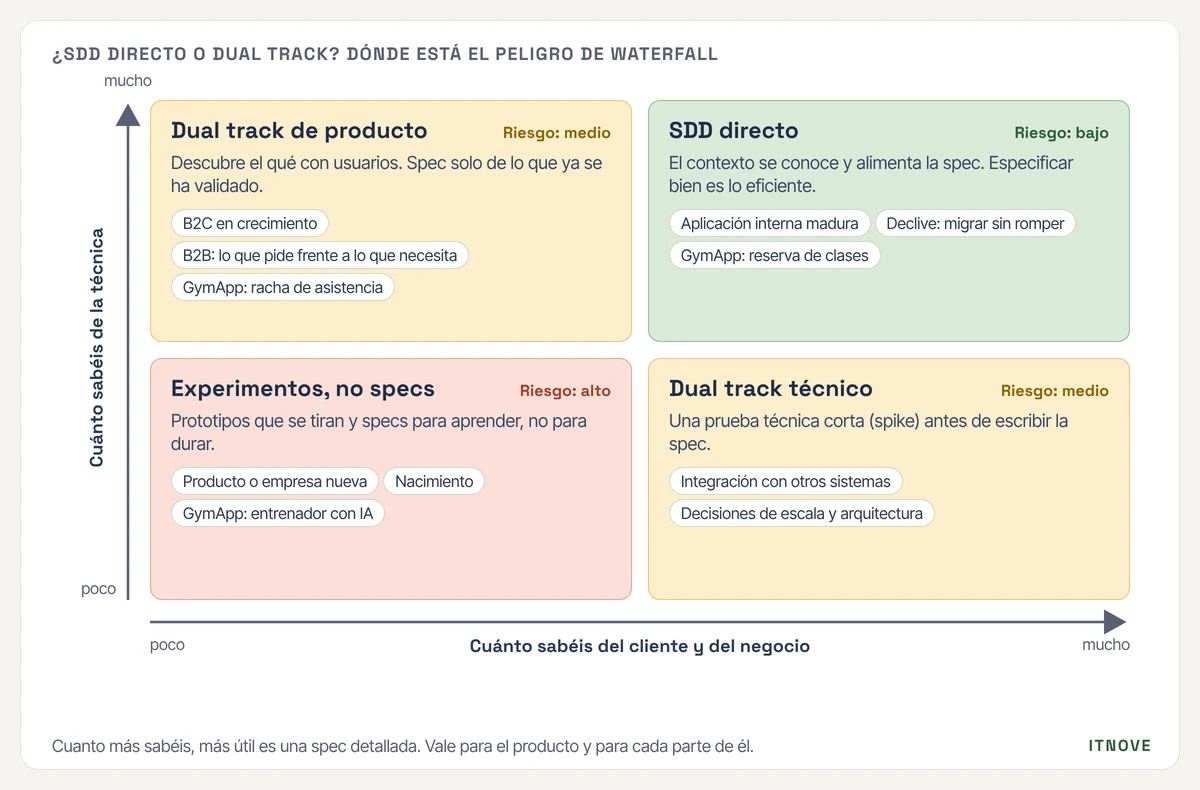
Las dos tablas se resumen en una pregunta doble: cuánto sabéis del cliente y del negocio, y cuánto de la técnica. Cruzadas, dan cuatro situaciones, y solo en una conviene escribir la spec completa desde el principio:
Dual track: descubrir qué construir antes de construirlo bien
Cuando el contexto tiene incertidumbre, la forma práctica de usar SDD sin caer en un waterfall es combinarlo con un dual track. Son dos corrientes de trabajo:
- Descubrir qué construir. El porqué y el qué: decisiones sobre el cliente, sobre un contexto técnico que todavía no es maduro y sobre la arquitectura. Aquí se trabaja con entrevistas, prototipos, datos de uso y pruebas técnicas cortas (spikes).
- Construir bien lo que ya se ha decidido. Cuando una decisión está madura, pasa a construcción (delivery): una spec lo bastante precisa para que un agente la convierta en código, agentes que generan, personas que revisan y la Definición de Done.
Dos aclaraciones prácticas. No son dos equipos, ni dos fases: el mismo equipo hace las dos cosas en el mismo Sprint, en proporciones distintas según la etapa y el tipo de aplicación. Y no todo pasa por descubrimiento: lo que ya es estable va directo a spec, y ahí SDD aporta toda su eficiencia.
En Scrum, esta separación encaja con el refinamiento estratégico y el táctico: el estratégico decide qué merece construirse; el táctico lo prepara para el Sprint. Y lo que se aprende en una corriente realimenta la otra.
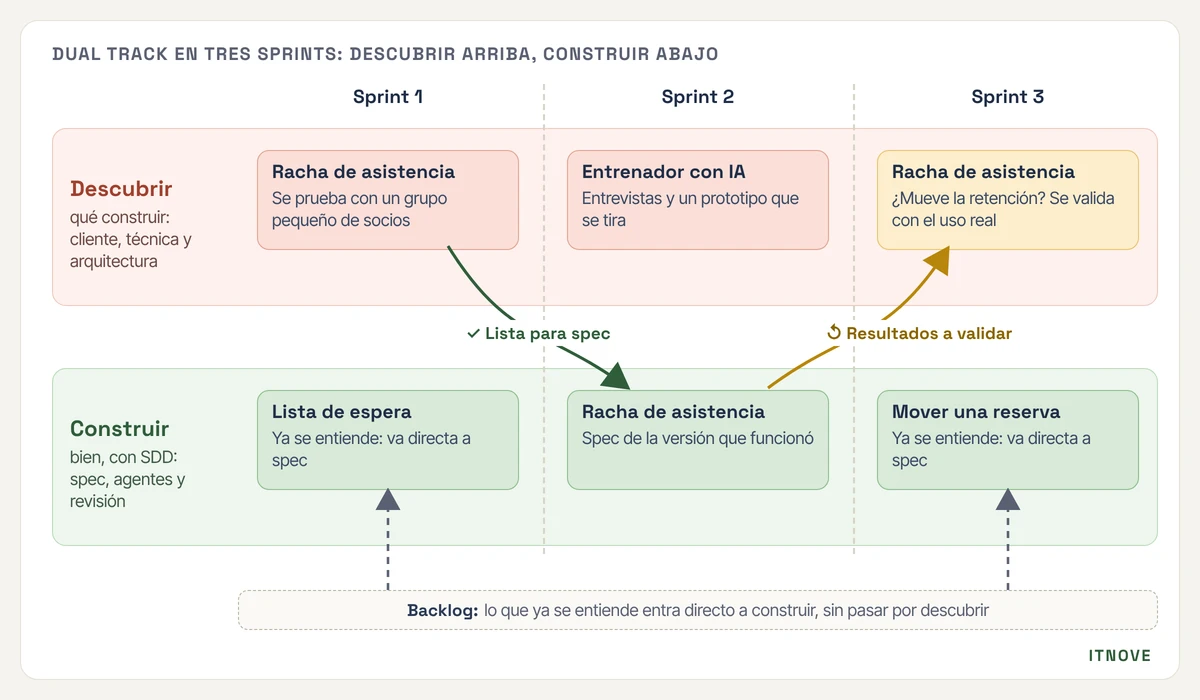
Así se ve en tres sprints de GymApp, la app del caso que usamos en formación (lo contamos con más detalle más abajo):
Cuándo una decisión está lista para convertirse en spec
Para que el paso de descubrir a construir no dependa de la intuición, ayuda tener unos criterios explícitos. Una parte del producto está lista para spec cuando:
- El problema está validado con usuarios o con datos, no solo con la opinión de quien lo pide.
- El alcance cabe en un Sprint o se puede partir en trozos que caben.
- Las decisiones técnicas están tomadas, o hay una prueba técnica corta que las ha despejado.
- Los criterios de aceptación se pueden escribir de forma verificable (por ejemplo, con Given/When/Then o EARS).
- Es poco probable que cambie durante el Sprint. Si el equipo espera que cambie a mitad, todavía es descubrimiento.
Si no se cumplen, la alternativa no es "no hacer nada": es un experimento, un prototipo desechable o una prueba técnica. Para eso, el vibe coding (pedirle a la IA que programe sin spec, conversando) es perfectamente razonable: sirve para aprender rápido, no para quedarse en producción.
Cómo vuelve lo aprendido a la Definición de Done
El dual track no es un embudo de una sola dirección. Lo que descubre el equipo cambia también qué significa "terminado":
- Un requisito de rendimiento o de accesibilidad que aparece al probar con usuarios reales pasa a ser un criterio de la Definición de Done.
- Un riesgo técnico descubierto en una prueba corta (una dependencia frágil, un dato sensible) se convierte en una comprobación que todo cambio debe pasar.
- Un error en producción que nadie previó se traduce en un nuevo criterio, o en un ajuste de la plantilla de spec.
Así, la Definición de Done y las specs mejoran con lo que se aprende al descubrir. Qué conviene revisar en la Definición de Done cuando la IA hace parte del trabajo lo contamos en ¿Cómo adaptar la Definición de Done al desarrollo con IA?.
Un ejemplo: tres funcionalidades de GymApp, tres tratamientos distintos
Este es el caso que usamos en formación: GymApp, la app de la cadena de gimnasios GymTonic, con Nuria como Product Owner. En el mismo producto conviven tres partes en etapas distintas.
La reserva de clases es una parte madura. Los socios la usan desde hace tiempo, las reglas de negocio se conocen y la arquitectura no da sorpresas. Una mejora (por ejemplo, la lista de espera) va directa a spec: contexto, alcance, criterios de aceptación y decisiones técnicas, y el agente la construye con revisión humana. Aquí, especificar bien es lo eficiente.
La racha de asistencia está en crecimiento. La hipótesis es que mostrar la racha mejora la retención, pero todavía no se sabe qué versión funciona. Nuria y el equipo prueban primero con un grupo pequeño de socios, miden y solo después escriben la spec de la versión que ha demostrado mover la retención.
Un entrenador con IA que propone rutinas está en nacimiento. No se sabe si los socios lo quieren, ni qué datos puede usar sin problemas de privacidad, ni qué arquitectura conviene. Aquí no hay spec de producto: hay experimentos pequeños, entrevistas y alguna prueba técnica desechable.
El mismo equipo, con el mismo método, en el mismo Sprint. La diferencia es cuánto descubrimiento hay antes de cada spec.
Cómo implantarlo según tu contexto
Una forma concreta de empezar, según dónde estés:
| Tu contexto | Qué hacéis cada Sprint | Qué medís |
|---|---|---|
| Aplicación interna madura | Casi todo es delivery con SDD; reservad una revisión con usuarios cuando entre algo nuevo | Retrabajo de specs y defectos que se escapan |
| B2B o a medida | Validad con el cliente antes de comprometer alcance; spec de lo acordado y validado | Cambios de alcance después de escribir la spec |
| B2C en crecimiento | Una parte del Sprint a descubrimiento (prototipos, pruebas con usuarios); spec solo de lo validado | Uso real de lo entregado y specs reescritas tras feedback |
| Producto o empresa nueva | Experimentos pequeños cada Sprint; specs de prototipos, no de producto final | Tiempo desde la idea hasta el primer feedback de usuario |
Quién decide qué pasa a spec: el Product Owner, con el equipo, en el refinamiento. Qué queda por escrito: los criterios de "lista para spec" que el equipo haya acordado. Y un límite a tener presente: si todo pasa siempre por descubrimiento, tampoco funciona. El objetivo no es explorar más, sino explorar donde hay incertidumbre y entregar con eficiencia donde no la hay.
Para empezar
Si quieres probar Spec-Driven Development en la parte estable de tu producto, el kit de Spec-Driven Development es gratuito: plantilla de spec, checklist de las cinco preguntas y una Definición de Done para código generado con IA.
Preguntas frecuentes
¿Spec-Driven Development es lo mismo que waterfall?
No necesariamente. Se parece a waterfall cuando se escriben specs grandes y cerradas antes de aprender y nadie las vuelve a abrir. No se parece cuando las specs son pequeñas, de partes que ya se entienden, y se reescriben con lo que aparece cada Sprint. Depende sobre todo del contexto.
¿Cuándo tiene sentido Spec-Driven Development sin mucho descubrimiento previo?
Cuando se conoce bien el contexto: productos o partes en madurez, aplicaciones internas con usuarios accesibles o cambios en sistemas cuya arquitectura no da sorpresas. Ahí el conocimiento acumulado alimenta la spec y SDD aporta toda su eficiencia.
¿Qué es el dual track y cómo se combina con Spec-Driven Development?
Son dos corrientes de trabajo del mismo equipo: descubrir qué construir (cliente, contexto técnico, arquitectura) y construir bien lo ya decidido. Con SDD, solo lo que está maduro pasa a spec; lo incierto sigue en descubrimiento con prototipos o pruebas cortas.
¿Cómo sé si una funcionalidad está lista para escribir su spec?
Cuando el problema está validado con usuarios o datos, el alcance cabe en un Sprint, las decisiones técnicas están tomadas, los criterios de aceptación se pueden escribir de forma verificable y no se espera que cambie durante el Sprint.
¿Spec-Driven Development sirve para una startup o un producto nuevo?
Sirve, pero de otra forma: para especificar experimentos y prototipos pequeños, no el producto final. En un producto nuevo casi todo es descubrimiento, y especificar demasiado pronto es el riesgo principal.
Recursos relacionados
- Specs que la IA convierte en código sin retrabajo: guía de Spec-Driven Development
- Vibe coding vs Spec-Driven Development: por qué las specs ganan al escalar
- Cómo integrar UX y Scrum: ¿Dual-Track Scrum?
- ¿Qué son el refinamiento estratégico y el refinamiento táctico?
- ¿Cómo hacer el Product Discovery con Scrum?
- ¿Cómo adaptar la Definición de Done al desarrollo con IA?
- Kit de Spec-Driven Development (gratis)